Яндекс открыл исходный код движка потоковой обработки данных YTsaurus Flow

Читайте в Telegram
|
Яндекс выложил в открытый доступ YTsaurus Flow — движок для потоковой обработки данных. Об этом компания рассказала на Хабре.
Обычно события вроде кликов, показов и заказов сначала накапливают и обрабатывают пакетами. Flow обрабатывает их по мере поступления и хранит состояние между событиями. По умолчанию движок учитывает каждое сообщение ровно один раз, без потерь и дублей, в том числе при сбоях оборудования. Там, где важнее сэкономить ресурсы, эту гарантию можно ослабить.
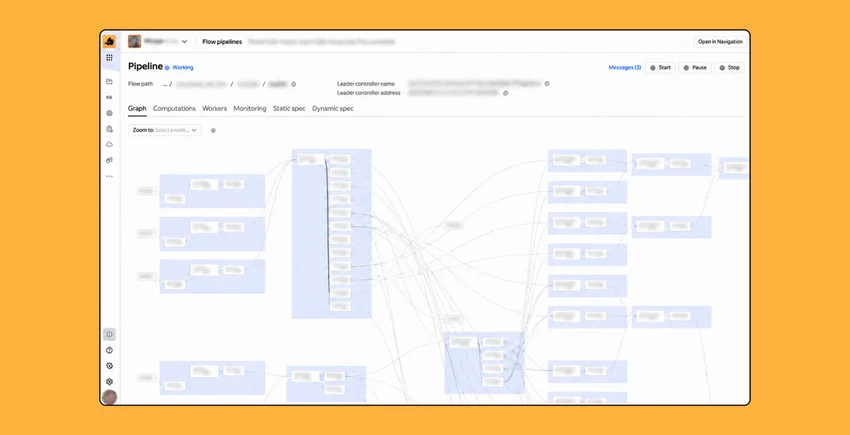
Flow разработали команды Yandex Infrastructure и «Яндекс Рекламы» для рекомендательных систем. По данным Яндекса, в «Рекламе» данные для дообучения моделей подбора объявлений раньше доходили до модели за десяток часов, после перехода на Flow — примерно за два. Движок, по словам компании, обрабатывает больше 100 ГБ данных в секунду, а ещё его используют «Маркет» и антифрод-системы.
Flow входит в YTsaurus — платформу для хранения и обработки больших данных, которую Яндекс выложил на GitHub в марте 2023 года. Движок работает с её хранилищем, очередями и транзакциями. В июне Яндекс также открыл код формата данных YaFF.
Код распространяется под лицензией Apache 2.0, которая допускает коммерческое использование. Среди существующих движков такого типа разработчики называют Apache Flink, Kafka Streams и Spark Structured Streaming.