Кодик кратко объясняет суть статьи
SpaceXAI представила обновлённую языковую модель Grok 4.7, ориентированную на программирование и сложные профессиональные задачи. Модель построена на более мощной архитектуре по сравнению с Grok 4.6 и прошла усиленное обучение с подкреплением, сфокусированное на длительных вычислительных задачах. Grok 4.7 показала улучшенную проверку результатов, работу с длинным контекстом и понимание оболочки Grok Bot. В бенчмарке GDPval она набрала 1695 баллов, опередив GPT-6 Astra (1542). В тестах на разработку ПО — CursorBench 4.0 и DeepSWE v1.1 — результаты составили 46,3% и 71% соответственно, что выше, чем у GPT-5.6 Sol. Модель получила усовершенствованные защитные механизмы: в тестах LatchBio и HackerBench v0.3 она продемонстрировала высокую безопасность — 62,4% и пропуск лишь 3,3% рискованных запросов. Партнёры получили доступ к редтимингу для исследований в цифровой обороне. Стоимость API осталась прежней — $2 за 1 млн входных и $6 за 1 млн выходных токенов, что выгоднее GPT-5.6 Sol. Доступна также ускоренная версия за двойную цену. Grok 4.7 уже интегрирована в Cursor, Grok Build и облачные платформы. Одновременно Яндекс объявил о запуске Alice AI Foundation — модели, обученной с нуля. Несмотря на то, что из 80 млрд параметров активны только 3 млрд, она превзошла более крупные модели DeepSeek и Nvidia в ряде тестов.
Читайте в Telegram
|
SpaceXAI представила флагманскую языковую модель Grok 4.7, ориентированную на написание программного кода и решение комплексных профессиональных задач
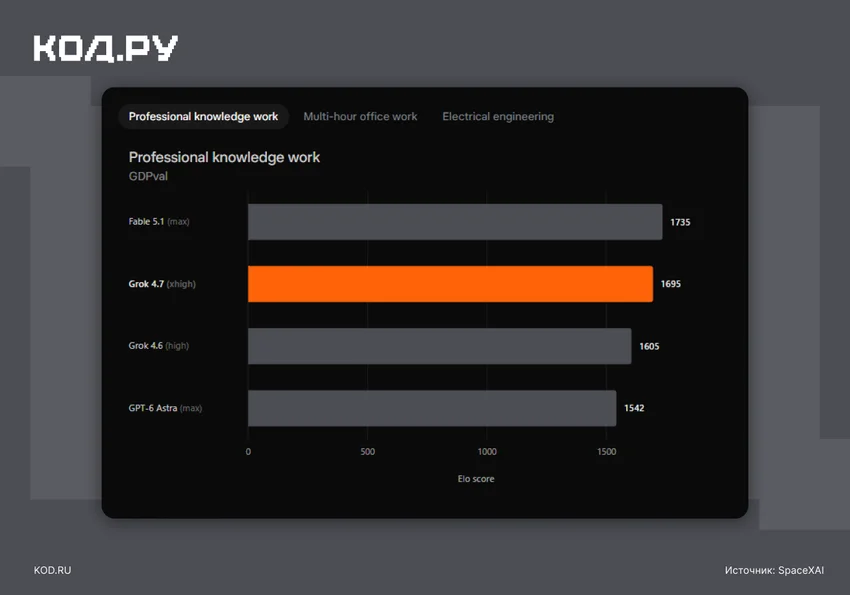
Новинка построена на базе более крупной модели по сравнению с Grok 4.6. Разработчики увеличили цикл обучения с подкреплением (RL), сместив акцент на задачи, требующие нескольких часов непрерывных вычислений. В результате Grok 4.7 научилась тщательнее верифицировать собственные результаты, эффективнее управлять длинным контекстом и нативно понимать оболочку Grok Bot. В бенчмарке GDPval, оценивающем создание презентаций и документов на уровне аналитиков и юристов, модель набрала 1695 баллов, обогнав GPT-6 Astra с её 1542 баллами.
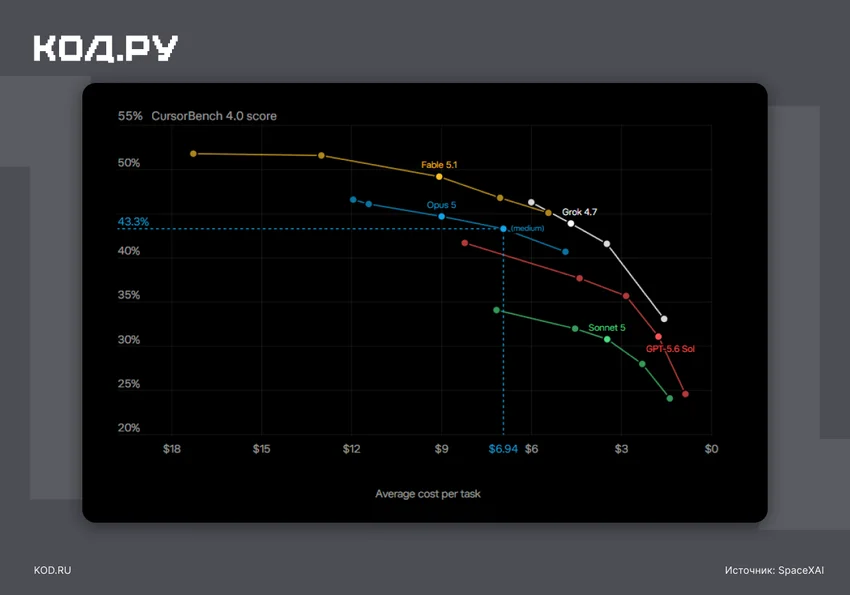
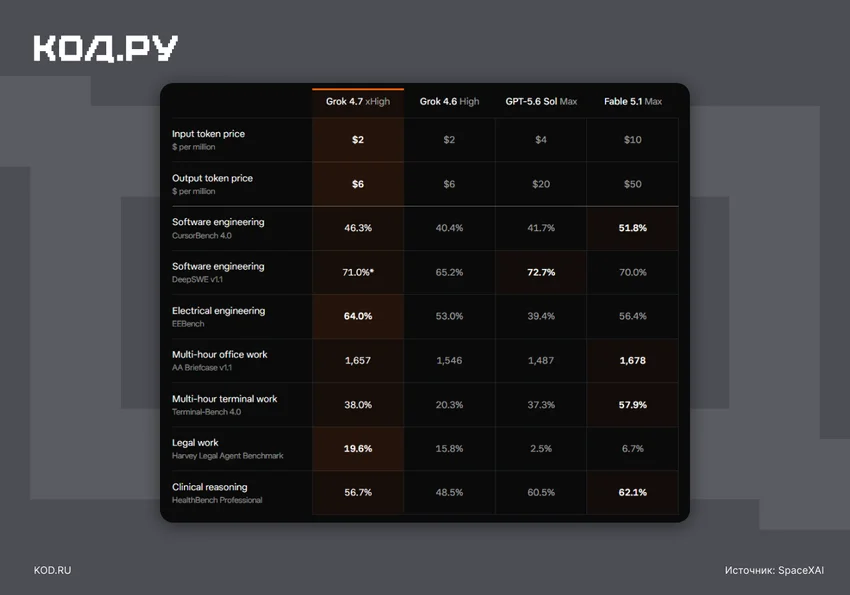
В профильных тестах по разработке программного обеспечения модель также продемонстрировала рост: в CursorBench 4.0 результат составил 46,3% против 41,7% у GPT-5.6 Sol, а в бенчмарке DeepSWE v1.1 в режиме глубоких рассуждений система достигла 71%.
Существенные изменения затронули безопасность: Grok 4.7 оснастили переработанным стеком защитных механизмов с высокой устойчивостью к взломам и джейлбрейкам. В тесте биобезопасности LatchBio показатель модели составил 62,4%, а в бенчмарке киберугроз HackerBench v0.3 система пропустила всего 3,3% рискованных запросов двойного назначения, сохранив при этом доступ к легитимным исследовательским инструментам. Отобранные компании-партнёры получили доступ к редтимингу модели для исследований в сфере цифровой обороны.
Стоимость использования API осталась на уровне предыдущей версии — $2 за 1 млн входных и $6 за 1 млн выходных токенов (для сравнения, у GPT-5.6 Sol расценки составляют $4 и $20 соответственно). Для задач с повышенными требованиями к отклику доступна быстрая версия с удвоенной скоростью генерации по двойной цене. Модель уже доступна в Cursor, среде Grok Build и облачных платформах.