Атаки на дата-центры Яндекса меняют правила. Как ритейл перестроит ИТ в 2027 году

Читайте в Telegram
|
Октябрьские атаки на дата-центры Яндекса показали российскому ритейлу новый тип инфраструктурного риска. Сбои затронули сервисы, от которых зависят продажи, платежи, реклама, логистика и работа сторонних компаний в облаке.
В отдельных случаях последствия сохранялись и после восстановления основных систем, поскольку бизнесу приходилось разбирать накопившиеся за время простоя операции.
До этого отказ крупного облачного или платформенного провайдера для многих компаний оставался сценарным риском. Теперь вопрос становится практическим: какие процессы остановятся, если недоступна основная площадка, сколько времени бизнес сможет работать в таком режиме и где взять мощности для восстановления.
В 2027 году это может заметно изменить подход к инфраструктурным бюджетам. Ритейлу придется больше тратить не только на защиту от атак, но и на устойчивость после инцидента: резервные площадки, каналы связи, альтернативных провайдеров, тестовые миграции и регулярную проверку сценариев восстановления.
Надежности одного провайдера больше недостаточно
Раньше компании могли строить отказоустойчивость вокруг предположения, что крупный поставщик сам обеспечит резервирование своих дата-центров. Октябрьские события показали ограниченность такой модели.
Если значительная часть сервисов, данных и бизнес-процессов сосредоточена у одного игрока, масштабный инцидент затрагивает сразу множество компаний. Для ритейлера это может означать одновременные проблемы с заказами, оплатой, рекламой, складскими операциями и логистикой.
Причем зависимость не всегда очевидна. Компания может не пользоваться инфраструктурой крупного провайдера напрямую, но зависеть от SaaS-сервиса, платежного партнера, логистической платформы или подрядчика, который размещает свои системы именно там.
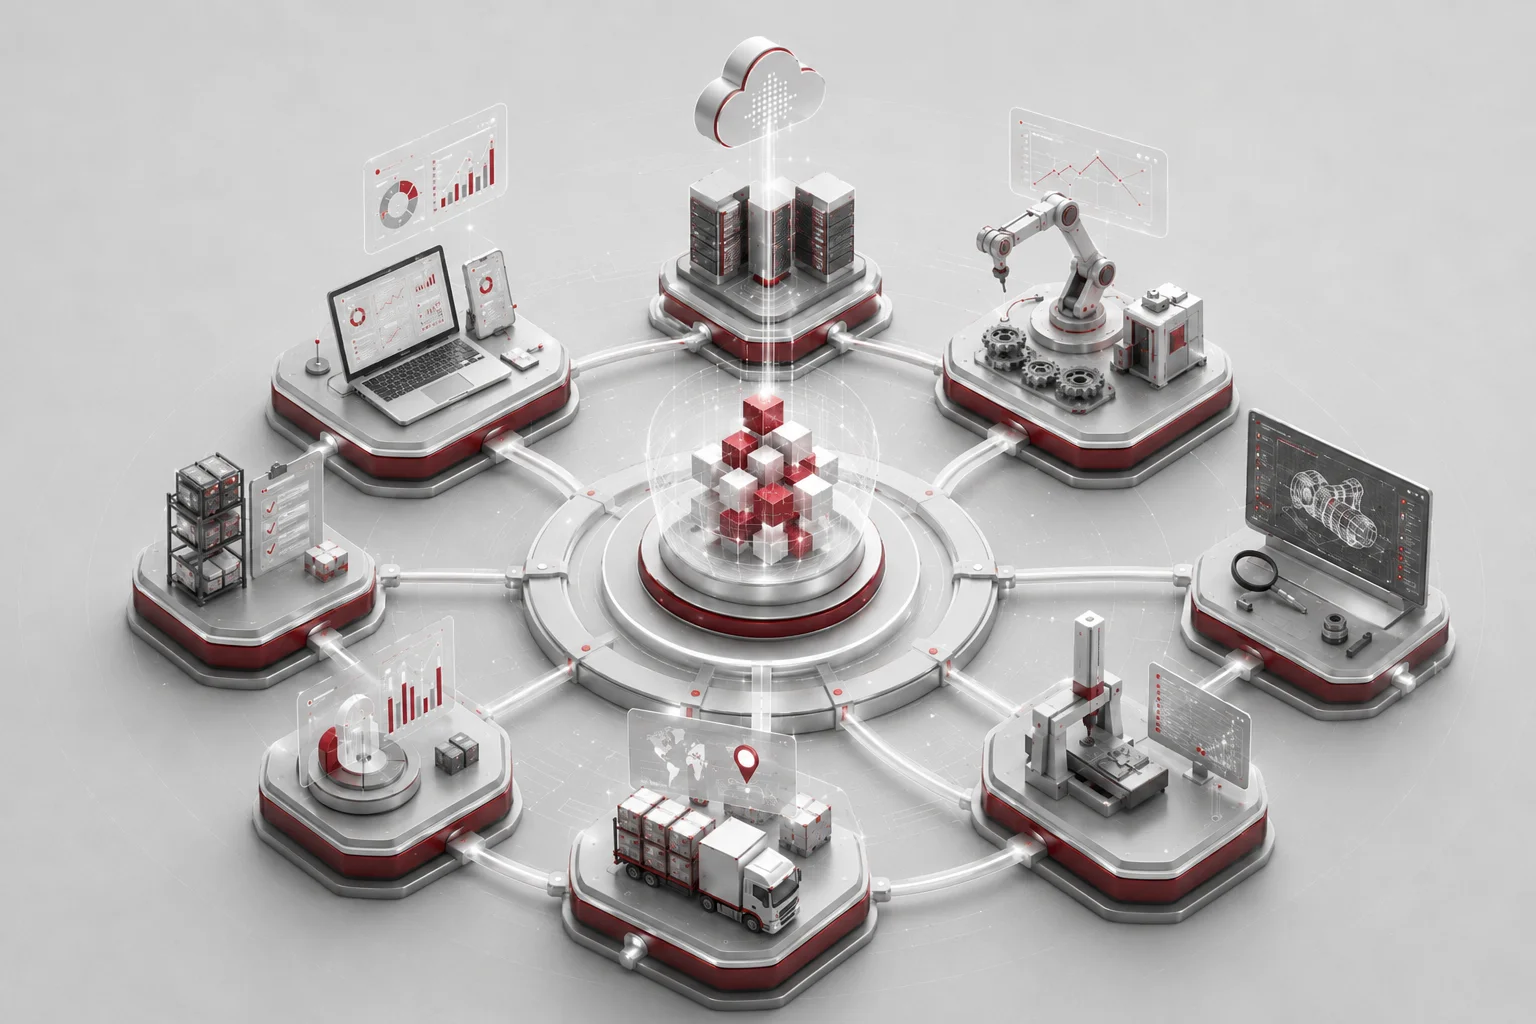
Поэтому в 2027 году бизнесу придется анализировать уже не только собственную инфраструктуру, но и цепочку технологических зависимостей. Вопрос будет звучать шире: какой внешний сервис критичен для продажи, оплаты и исполнения заказа, где он размещен и есть ли рабочий сценарий на случай его недоступности.
Диверсификация станет отдельной статьей ИТ-бюджета
Полное дублирование инфраструктуры дорого. Нужно поддерживать вторую площадку, резервные каналы, синхронизацию данных, дополнительные лицензии, мониторинг и процессы переключения. Но стоимость длительного простоя для крупного ритейлера тоже быстро становится значительной.
В 2027 году компании, скорее всего, будут чаще выбирать дифференцированный подход. Самые критичные сервисы получат более жесткое резервирование, для менее значимых систем бизнес сможет ограничиться резервной облачной площадкой или возможностью быстро развернуть мощности у другого провайдера.
«Диверсификация действительно требует денег — нужно продублировать площадки, создать резервные каналы, синхронизировать данные, провести все необходимые тесты, но эти расходы вполне сопоставимы с затратами, которые неизбежны после длительного простоя. Но диверсификацию тоже можно диверсифицировать! Для этого нужно сначала оценить критичность процессов, а затем принимать взвешенное решение. Критически важные процессы потребуют полного дублирования ИТ-инфраструктуры в собственном контуре, для менее значимых достаточно арендовать облако», — говорит Мария Соловьева, руководитель направления серверной инфраструктуры и систем хранения данных компании «ГИГАНТ — Компьютерные системы».
Такой подход требует заранее определить приоритеты восстановления. Для интернет-магазина одинаково неприятны сбой внутренней аналитики и невозможность принять оплату, но последствия для бизнеса разные. Поэтому резервирование должно начинаться с процессов, остановка которых сразу влияет на выручку, исполнение заказов или обязательства перед клиентами.
Одновременно изменится отношение к резервным копиям. Сам факт наличия копии еще не гарантирует быстрое восстановление. Компании нужны вычислительные мощности, сеть, доступы, актуальные настройки приложений и проверенный порядок запуска. Если этот сценарий ни разу не тестировался, фактическое время восстановления может сильно отличаться от расчетного.
Второе облако нельзя подключить одной кнопкой
После крупного сбоя естественным кажется решение быстро перенести нагрузку к другому облачному провайдеру. На практике массовая миграция упирается в физические ограничения.
Дата-центр располагает конечным количеством серверов, стоек, электрической мощности и систем охлаждения. Если большое количество клиентов одновременно запрашивает дополнительные ресурсы, свободной емкости может не хватить. Особенно это касается нестандартных серверных конфигураций и оборудования, которое сложно оперативно приобрести.
Кроме того, перенос приложения требует подготовки. Нужно переместить данные, проверить сетевую связность, настроить доступы, восстановить интеграции и убедиться, что сервис работает с необходимой производительностью. Для крупных систем это занимает значительно больше времени, чем оформление нового аккаунта у провайдера.
«Альтернативные провайдеры способны принять часть нагрузки, но не весь объем в одну секунду. Ограничениями становятся физическая емкость дата-центров и доступность дефицитных комплектующих. Переключение потребует времени на заключение договоров, миграцию данных, обеспечение совместимости и тестирование. На практике возможен поэтапный перенос критически важных функций и пиковое распределение нагрузки, но при масштабном выходе инфраструктуры одного крупного оператора весь рынок почувствует дефицит и ценовое давление», — отмечает Мария Соловьева, руководитель направления серверной инфраструктуры и систем хранения данных компании «ГИГАНТ — Компьютерные системы».
Отсюда следует еще одно изменение на 2027 год: резервного провайдера придется выбирать до аварии. Сам договор без технической подготовки тоже мало помогает. Компаниям понадобится заранее определить конфигурации, проверить совместимость, протестировать перенос данных и хотя бы периодически поднимать критичные сервисы на запасной площадке.
Авария у одного игрока может поднять цены для остальных
Крупный инфраструктурный сбой влияет и на компании, которых он напрямую не затронул. Если пострадавшие организации одновременно начинают арендовать дополнительные серверы или срочно покупать оборудование, спрос увеличивается сразу на нескольких направлениях.
Это создает конкуренцию за серверы, память, СХД и свободные мощности дата-центров. В условиях ограниченных поставок срочные закупки могут оказаться дороже плановых, а сроки поставки увеличиться.
Для ритейла это особенно чувствительно перед периодами высокой нагрузки. Инфраструктура должна выдерживать распродажи, сезонные пики и рост количества заказов. Если резервирование начинают строить уже после крупного инцидента, свободные мощности приходится искать одновременно с другими участниками рынка.
Поэтому в 2027 году часть компаний может перейти от аварийных закупок к предварительному резервированию ресурсов. Это могут быть рамочные контракты с несколькими поставщиками, заранее согласованные конфигурации, резерв мощности в облаке или оборудование, которое можно быстро ввести в эксплуатацию.
Такой подход увеличивает регулярные расходы, но делает стоимость восстановления более предсказуемой.
ИТ-бюджет придется считать с учетом аварии
Последствия атак затрагивают не только ритейлеров. Операторы дата-центров и облачные провайдеры также вынуждены усиливать резервирование, физическую защиту площадок, запас оборудования и процедуры восстановления.
Часть этих затрат со временем может попасть в стоимость облачных сервисов. Одновременно самим компаниям придется увеличивать бюджеты на резервные мощности и информационную безопасность.
«В ближайшие месяцы затраты продолжат расти: операторы ЦОДов увеличат расходы на восстановление, резервирование и физическую защиту, часть этих затрат может со временем войти в тарифы облачных услуг. Ритейл должен заложить дополнительные бюджеты на резервные мощности, страхование, тестовые миграции, контракты с альтернативными поставщиками и увеличение расходов на информационную безопасность», — считает Мария Соловьева, руководитель направления серверной инфраструктуры и систем хранения данных компании «ГИГАНТ — Компьютерные системы».
Для 2027 года важен сам характер этих расходов. Раньше инфраструктурный бюджет можно было условно разделить на развитие и эксплуатацию. Теперь заметнее становится еще одна часть — готовность к отказу основной площадки.
В нее входят резервные каналы, дополнительные ресурсы, проверка резервных копий, сценарии аварийного переключения и регулярные тесты. Эти расходы не увеличивают продажи напрямую, поэтому раньше их было проще откладывать. После событий 2026 года бизнесу придется сравнивать их уже с потенциальной стоимостью простоя.
Мультиоблачность подойдет не всем
Одним из ответов на инфраструктурные риски станет использование нескольких облачных провайдеров. Но сама по себе работа с двумя облаками устойчивость не гарантирует.
Если все данные находятся только у одного поставщика, второе облако не поможет быстро запустить сервис. То же произойдет, если приложение сильно зависит от специфичных сервисов основной платформы, а команда никогда не проверяла запуск в другой среде.
Полноценная мультиоблачная архитектура требует переносимых приложений, репликации данных, независимых механизмов доступа и мониторинга, а также регулярного тестирования.
Для части ритейлеров такая схема окажется слишком дорогой. Поэтому более реалистичной стратегией станет резервирование отдельных критичных функций. Например, компания может оставить основной контур у одного провайдера, но иметь альтернативный сценарий для приема заказов, платежей, учета остатков или ключевых внутренних систем.
То есть в 2027 году рынок, вероятно, будет двигаться не к повсеместному дублированию всего ИТ-ландшафта, а к выборочному резервированию тех процессов, остановка которых непосредственно влияет на выручку.
Резервировать придется не только серверы
События октября показали еще одну проблему: цифровая зависимость ритейла значительно шире инфраструктуры интернет-магазина.
Продажа может остановиться, если недоступен платежный сервис. Склад может иметь товар, но не получить задания на отгрузку. Рекламная кампания может продолжать работать, пока сотрудник не имеет доступа к инструментам управления. После восстановления основного сервиса накопившаяся очередь операций еще некоторое время влияет на бизнес-процессы.
Поэтому план устойчивости должен включать всю цепочку продажи.
В 2027 году крупным ритейлерам придется проверять, есть ли альтернативный способ принять платеж, сохранить заказ, получить сведения об остатках и передать информацию в логистику. В некоторых случаях достаточно резервного канала или локальной выгрузки критичных данных, в других потребуется отдельный сервис.
Особенно важна независимость информации, необходимой для восстановления операций. Если сведения о заказах, платежах или остатках можно получить только из одного внешнего кабинета, при его недоступности компания теряет не только сервис, но и оперативную картину происходящего.
Проверка восстановления станет важнее самого плана
У многих компаний уже есть планы аварийного восстановления. Проблема в том, что документ не показывает, сможет ли система действительно заработать на резервной площадке.
Проверка должна включать запуск приложения, восстановление данных, работу интеграций и доступ пользователей. Для критичных сервисов необходимо заранее определить допустимое время простоя и объем данных, который бизнес может потерять без критичных последствий.
Если компания рассчитывает восстановить интернет-магазин за два часа, этот показатель должен быть подтвержден тестом. Иначе во время реального сбоя могут обнаружиться давно не проверявшиеся резервные копии, несовместимые версии ПО или отсутствующие доступы.
Поэтому в 2027 году инфраструктурная зрелость все чаще будет измеряться не количеством резервных серверов, а способностью компании доказать, что она умеет восстановить ключевые процессы в заданный срок.
Что изменится в 2027 году
Главный итог атак на инфраструктуру крупного провайдера для ритейла заключается в изменении самого представления о надежности.
Раньше бизнес в первую очередь оценивал доступность сервиса в обычных условиях. Теперь придется учитывать сценарий, в котором недоступна целая площадка, несколько связанных сервисов или значительный объем вычислительных мощностей.
Это изменит закупки и архитектуру. Компании будут чаще держать несколько поставщиков, заранее резервировать мощности, тестировать перенос сервисов и разделять системы по критичности. В инфраструктурных бюджетах вырастет доля расходов на резервирование и восстановление.
Облако при этом не потеряет привлекательность. Оно останется одним из способов быстро получать дополнительные ресурсы. Изменится другое: использование одного провайдера перестанет автоматически восприниматься как достаточная стратегия надежности.
Для ритейла 2027 год может стать периодом перехода от резервирования «на бумаге» к проверяемой устойчивости. Компании будут оценивать не только вероятность сбоя, но и то, сколько часов они смогут работать без конкретного сервиса и сколько будет стоить его восстановление.
После событий 2026 года вопрос для бизнеса звучит уже не «может ли крупная инфраструктура отказать». Гораздо важнее понимать, что именно компания будет делать, когда это произойдет.